



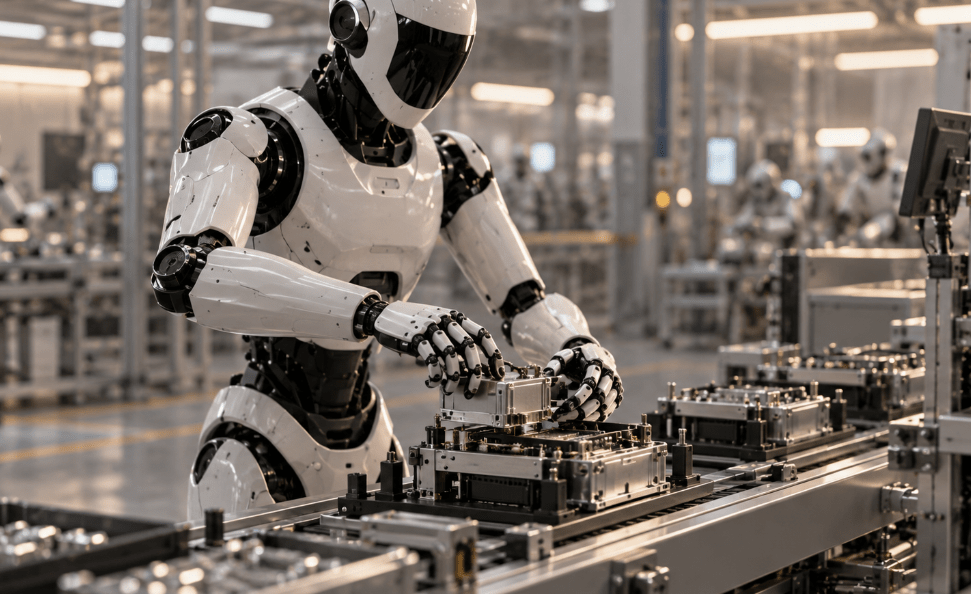
先进制造
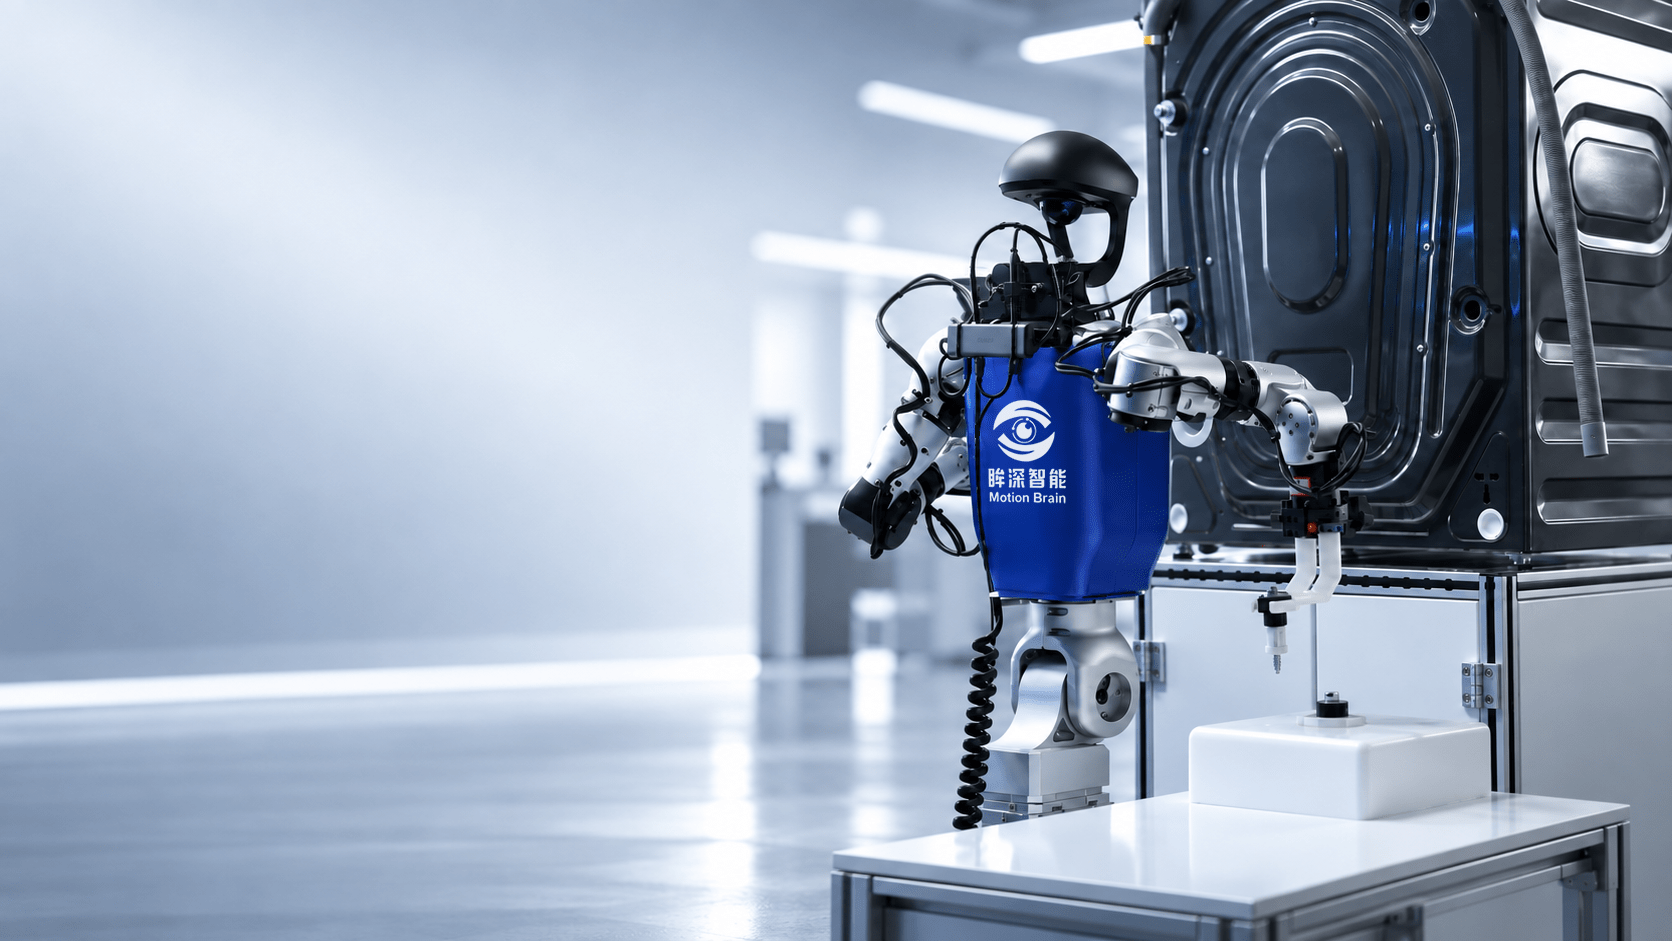
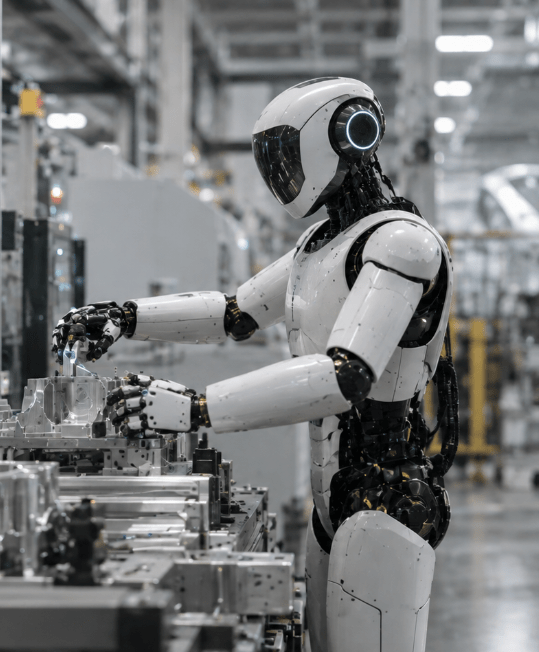
让机器人适应多产品、多工位与动态生产环境,从固定自动化走向自主作业。
眸深智能专注于生成式通用具身大脑,致力于让机器人具备理解世界、
生成动作、持续学习与自主进化的原生智能。
我们以 World Motion Model(世界动作模型) 为核心技术路线,打通三
维世界理解、动作生成、时空推演、端侧部署与软硬协同,构建从感知、
认知到行动的完整具身智能技术栈。
全球首款生成式具身大模型
实现文本指令到高保真动作的端到端映射,支持跨模态动作描述、预测与衔接,相关成果发表于 NeurIPS 等国际顶级会议,并获 NVIDIA 等国际团队多次引用
离线部署后仍可持续学习
将世界理解、状态预测与动作生成统一到同一模型中,支持机器人离线部署后的持续学习与自主进化。公开测试显示,模型离线运行后性能仍可提升,最高绝对提升达 25%,突破传统机器人模型部署后的能力固化
全球首款跨模态一体化大模型
直接以原始点云为输入,将三维空间理解与语言交互结合,支持 3D 问答、场景描述、文本指令交互、多轮具身对话与场景规划。相关成果获 ICCV 全球三维目标识别大赛冠军,并获 CVPR 2024 三维密集语义推理与描述第一
类人思维方式的三维世界模型
将物体、空间关系与视觉细节纳入统一建模,以空间信息检索、环境聚合与任务推理建立对真实三维环境的结构化理解,为机器人提供从场景认知到任务决策的世界模型能力
空间 × 时间 × 动作
探索用更少的真实机器人数据获得更精准、更具泛化能力的动作。模型同时关注环境状态、动态变化与动作结果,为机器人预测与生成下一步行动提供基础
让机器人适应多产品、多工位与动态生产环境,从固定自动化走向自主作业。
面向零售门店、商业空间及园区等场景,支持零售服务、导览接待、
物业协作与环境清洁等多类任务。
面向养老、医疗陪护及家庭生活场景,支持陪伴照护、康复辅助与日
常家务等多类任务。
面向仓储、园区及物流环境,支持长程任务与多机器人协同作业。
构建连接虚拟与真实世界的训练基础设施,支持 3D 空间理解、数据
采集、任务规划与模型训练。
与产业伙伴、科研机构及技术平台共同推进具身智能
技术创新与规模化落地
我们使用 Cookie 为您提供最佳体验。继续使用本网站,即表示您同意我们使用 Cookie。
了解更多关于我们使用的 Cookie 及如何识别它们的信息。